Article initialement publié en 2021, mis à jour le 3 novembre 2026.
Depuis les mises à jour Panda (qui déclasse les contenus de faible qualité) et Hummingbird (qui interprète l’intention derrière les requêtes), Google repère mieux les pages qui reprennent un contenu déjà publié, sur le même site ou ailleurs. Le contenu dupliqué ne vaut pas forcément une sanction, mais il disperse l’exploration, les liens et le classement entre plusieurs adresses. Cet article détaille ses causes les plus fréquentes et les corrections à appliquer.
L’essentiel à retenir
- Le contenu dupliqué désigne un contenu identique ou quasi identique accessible à plusieurs URL, sur un même site ou sur des domaines distincts.
- Google dit ne pas pénaliser la duplication accidentelle, mais la copie volontaire ou le bourrage de mots clés exposent au déclassement des pages (algorithme Panda).
- Les doublons gaspillent le budget de crawl, brouillent le choix de la version à classer et diluent les backlinks, au point qu’un site plagiaire puissant peut vous surpasser.
- Causes fréquentes : navigation à facettes, versions http, https et www, URL mobiles, sites multilingues, recherche interne, préproduction indexée, casse, barre oblique finale, tags et pagination.
- Quelques doublons ne posent pas problème ; une balise canonique autoréférentielle désigne la version de référence de chaque page, et Google sanctionne aussi le contenu produit en masse sans valeur ajoutée.
Qu’est-ce que le contenu dupliqué ?
Le contenu dupliqué est un contenu identique ou quasi identique accessible à plusieurs adresses web. La duplication peut se produire au sein d’un même site (duplication interne) ou entre des domaines distincts (duplication externe). Dès qu’un même texte répond à plus d’une URL, Google doit choisir laquelle afficher.
Comment survient le duplicate content ?
Le contenu dupliqué a deux origines, l’une le plus souvent involontaire, l’autre volontaire :
- des doublons créés par le fonctionnement même du site : paramètres d’URL, versions http et www, pages de tags, pagination ;
- la copie du contenu d’un autre site, qui peut faire perdre à la page sa crédibilité de source fiable, voire entraîner son déclassement.
Google indique que la plupart des contenus dupliqués ne relèvent pas d’une intention de tromper, et qu’il n’existe pas de pénalité pour le contenu dupliqué en tant que tel.
Dans les faits, Google distingue deux situations :
- Le doublon est accidentel et ne cherche pas à manipuler les résultats de recherche : pas de sanction, Google regroupe les URL et en affiche une.
- La duplication est volontaire, massive, ou accompagnée de pratiques comme le bourrage de mots clés (répétition abusive d’une même expression) : les pages concernées risquent le déclassement, voire une action manuelle au titre des règles sur le spam.
Pourquoi les moteurs de recherche n’aiment pas les contenus dupliqués ?
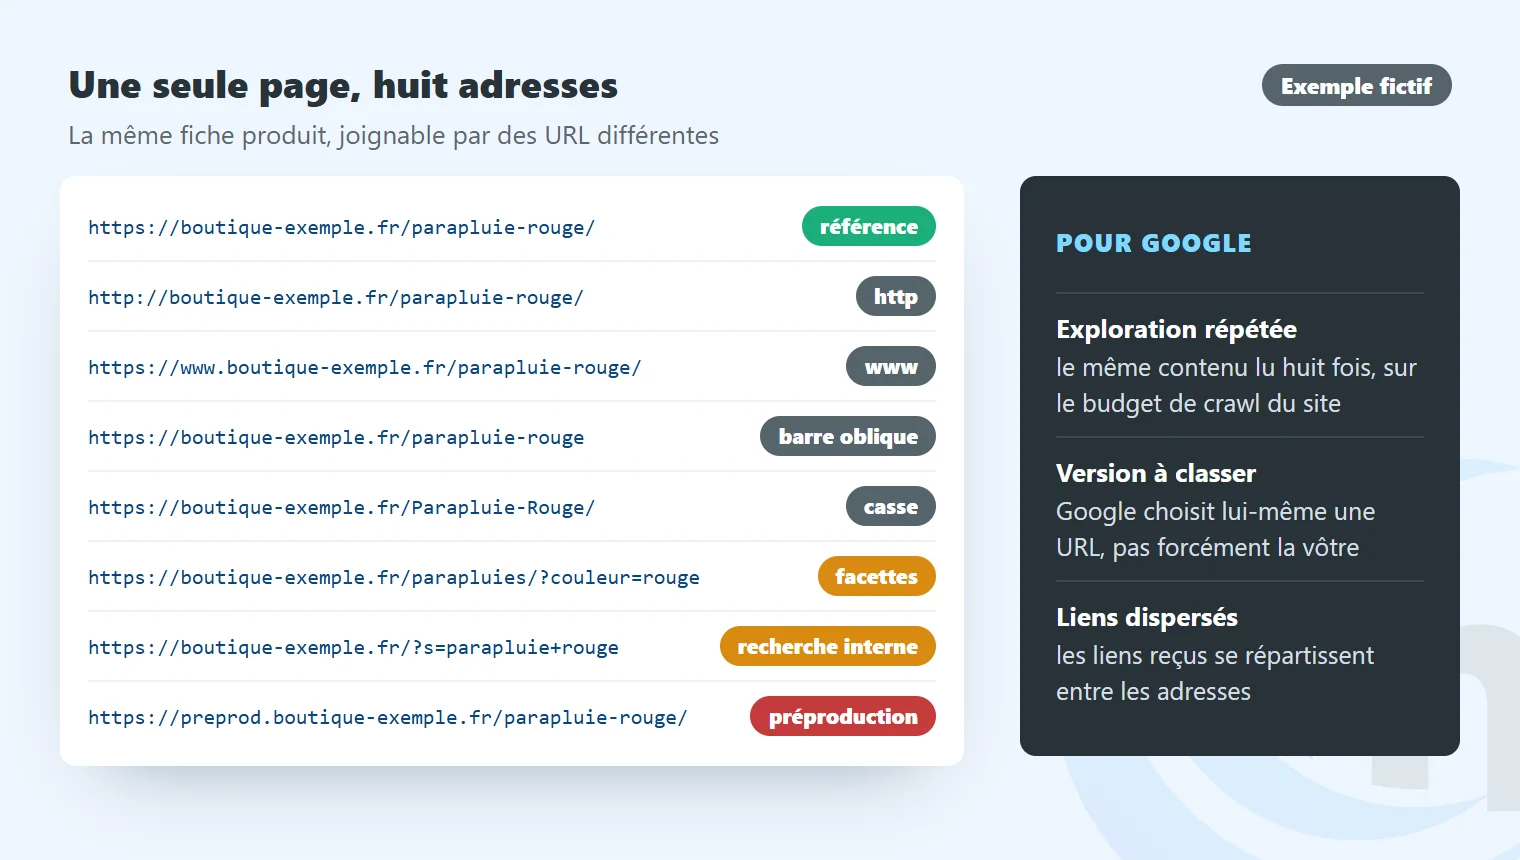
Un moteur de recherche cherche à afficher la source la plus utile pour une requête donnée. Quand plusieurs pages proposent le même contenu, il doit déterminer laquelle classer, et son choix ne correspond pas toujours à la page que vous auriez retenue. Le contenu dupliqué pose aussi d’autres problèmes :
- Le budget de crawl est consommé par des pages en double, ce qui peut retarder l’exploration de vos nouvelles pages ou de celles que vous venez de mettre à jour.
- Les liens retour ou backlinks se répartissent entre plusieurs URL au lieu de renforcer une seule page. Et lorsqu’un site à forte autorité reprend votre texte, il peut se classer devant vous.
- Des URL peu lisibles, chargées de paramètres, peuvent s’afficher dans les résultats à la place de la page voulue.
Les cas de duplication de contenu les plus courants
Dans la grande majorité des cas, les éditeurs de sites ne créent pas de contenu dupliqué volontairement. Les causes techniques sont nombreuses ; les connaître permet de corriger celles qui touchent déjà votre référencement naturel, ou de les éviter lors d’une refonte.
Pour rédiger un texte propre à chaque page, voyez aussi notre article sur la rédaction web.
Navigation à facettes, le système de filtre sur les sites e-commerce
La navigation à facettes répond à un vrai besoin : filtrer et trier les produits d’une catégorie. Mais chaque filtre ajoute des paramètres à la fin de l’URL, et chaque combinaison crée une nouvelle adresse dont le contenu reste proche de la page catégorie. Avec quelques filtres combinés, un catalogue peut produire des milliers d’URL quasi identiques.
Versions http, https, avec ou sans www
Un site doit répondre à une seule adresse : en https avec un certificat valide, avec ou sans www selon votre choix. Beaucoup de sites restent pourtant accessibles sous plusieurs formes, ce qui duplique chaque page. Si votre site s’affiche à chacune des adresses suivantes, il est concerné :
- https://mon-joli-site.com (https, non-www)
- https://www.mon-joli-site.com (https, www)
- http://mon-joli-site.com (http, non-www)
- http://www.mon-joli-site.com (http, www)
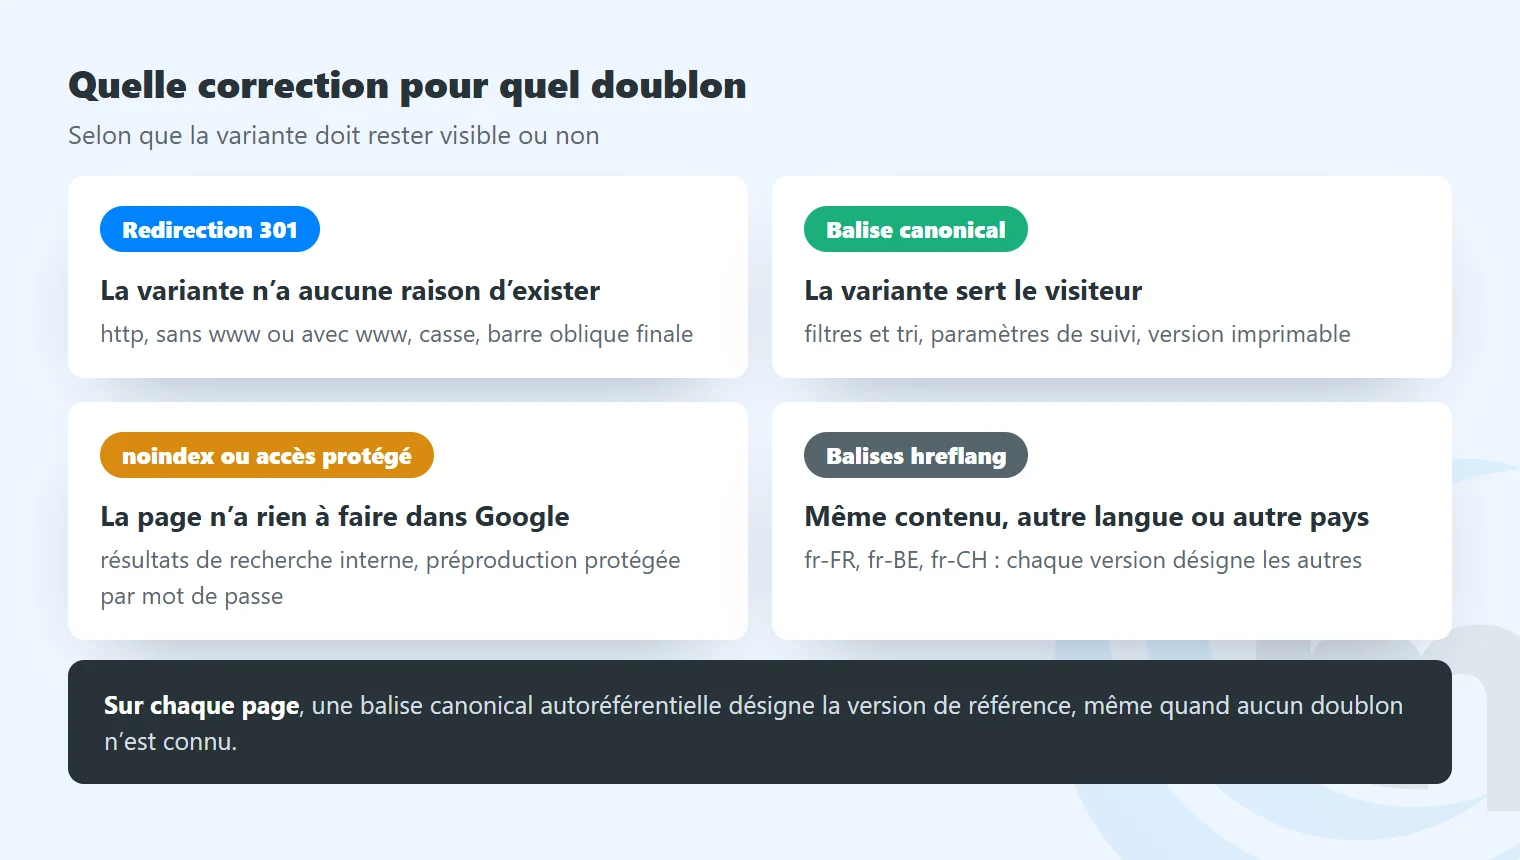
Dans ce cas, tout le site existe en quatre exemplaires. La correction consiste à rediriger en 301 les trois variantes vers la version retenue. Si vous ne savez pas comment le vérifier, demandez-nous un pré-audit SEO gratuit.
La gestion des urls destinées aux mobiles
Un site mobile séparé, sur un sous-domaine en « m. », duplique lui aussi les pages de la version ordinateur :
- mon-super-site.com/article
- m.mon-super-site.com/article
Si vous conservez ce fonctionnement, signalez la version mobile sur la page ordinateur avec rel= »alternate », et la version ordinateur sur la page mobile avec rel= »canonical ». Depuis le passage à l’indexation orientée mobile, un site adaptatif, qui sert la même URL à tous les écrans, évite le problème.
La gestion des sites multi-langues
Proposer un contenu similaire à des publics situés dans des pays différents mais parlant la même langue crée des pages presque identiques.
Par exemple, un site décliné pour la France, la Belgique et la Suisse affiche des pages qui ne diffèrent que par quelques détails, comme les coordonnées ou les conditions de livraison. Ces quasi-doublons se gèrent avec les balises hreflang : chaque version désigne les autres, et Google affiche celle qui correspond à la langue et au pays de l’internaute.
La génération de contenus dupliqués par le moteur de recherche interne du site
Le moteur de recherche interne d’un site produit une URL par recherche effectuée :
Exemple : /?s=seo
Ces pages de résultats n’ont pas à être explorées ni indexées. Bloquez leur exploration dans le fichier robots.txt, ou appliquez-leur une balise noindex, pour ne pas multiplier les URL inutiles.
La version de préproduction peut créer du contenu dupliqué
Une préproduction est une copie du site qui sert à tester les modifications avant leur mise en ligne. Si Google la trouve et l’indexe, elle duplique tout le site. Protégez-la par un mot de passe, la solution la plus sûre, ou au minimum par une balise noindex.

Les urls sensibles à la casse créent des cas de duplication de contenu
Google traite les URL comme sensibles à la casse. Ces trois adresses sont donc différentes pour lui, alors qu’elles affichent le même contenu :
- exemple.fr/contenu
- exemple.fr/CONTENU
- exemple.fr/CoNtenU
La correction passe par une règle de réécriture qui redirige en 301 toute variante vers l’URL en minuscules, et par des liens internes écrits toujours de la même façon.
Le duplicate content causé par les tags et les catégories dans l’url
La plupart des CMS créent des pages de tags dédiées lorsque vous les utilisez. Par exemple, si vous avez un article sur le référencement naturel à Paris, et que vous utilisez à la fois « SEO Paris » et « SEO IDF » comme tags, vous vous retrouverez avec deux pages de tags comme celles-ci :
- https://www.mon-super-seo.com/tag/seo-paris/
- https://www.mon-super-seo.com/tag/seo-idf/
Cela ne crée pas toujours de doublon, mais c’est le cas ici : un seul article porte ces deux tags, donc les deux pages affichent exactement la même liste. Les pages de tags peu fournies gagnent à recevoir une balise noindex.
Barre oblique ou non à la fin des urls, une source potentielle de contenu dupliqué
Pour Google, une URL avec barre oblique finale et la même URL sans barre oblique sont deux adresses distinctes :
- exemple.fr/seo-normandie/
- exemple.fr/seo-normandie
Si votre contenu répond aux deux, il est dupliqué. La correction : rediriger en 301 une forme vers l’autre. Faites l’essai avec cet article : l’adresse sans barre oblique finale redirige vers https://maxelik.com/le-contenu-duplique-un-virus-pour-le-referencement/.
Les urls des images jointes peuvent produire des contenus dupliqués
De nombreux CMS créent des pages dédiées aux images jointes. Ces pages n’affichent généralement que l’image et un texte générique. Comme ce contenu est le même sur toutes les pages générées automatiquement, cela conduit à un contenu dupliqué. Sur WordPress, rediriger ces pages vers le fichier lui-même règle le problème : Yoast SEO le fait par défaut.
La pagination peut créer des contenus dupliqués
Une pagination mal gérée produit des pages aux titres et descriptions identiques (page 2, page 3…). Donnez à chaque page de la série sa propre URL et sa propre balise canonique, sans les faire toutes pointer vers la première, et reliez-les par des liens classiques que Google peut suivre.
Devez-vous vous alarmer dès les premiers contenus dupliqués ?
Une poignée de pages en double ne pose pas de problème, pas plus qu’une citation d’un autre site ou d’une autre page du vôtre. Google regroupe ces doublons et affiche une seule version.
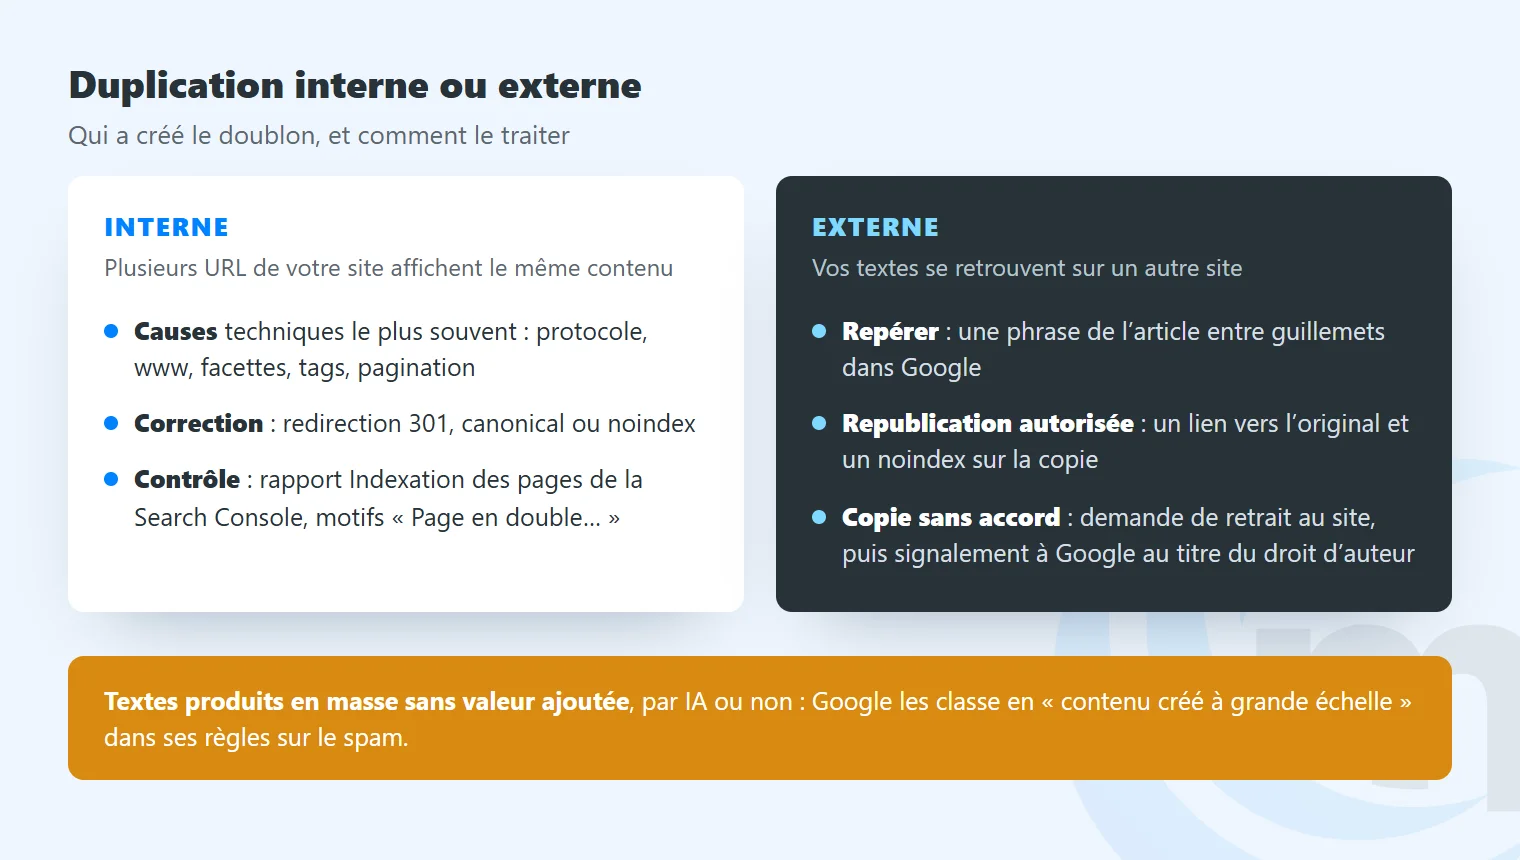
Surveillez en revanche les erreurs techniques qui génèrent des centaines, voire des milliers de pages en double : le rapport Indexation des pages de la Search Console les signale.
Comment protéger mon contenu de la duplication par le vol de contenu ?
Une balise canonique autoréférentielle, c’est-à-dire un lien rel= »canonical » qui pointe vers l’URL de la page elle-même, aide Google à identifier l’original lorsqu’un site recopie votre page avec son code source.

Si la copie reste en ligne, demandez son retrait au site concerné, puis signalez-la à Google au titre du droit d’auteur.
Ces cas couvrent l’essentiel des doublons que nous rencontrons lors de nos audits. Traités tôt, ils évitent une baisse du trafic organique difficile à expliquer après coup.
Le contenu dupliqué en 2026 : attention à l’IA
À la duplication classique, interne ou externe, s’ajoute le contenu produit en masse, notamment par IA : Google range le « contenu créé à grande échelle » sans valeur ajoutée dans ses règles sur le spam. La réponse reste la même : des contenus originaux et utiles, des balises canoniques cohérentes et une ligne éditoriale suivie. Pour produire du contenu unique, voyez comment écrire de bons contenus web ; pour détecter les duplications, un audit SEO fait le point.
Sources
- Google Search Central : spécifier une URL canonique avec rel= »canonical » et d’autres méthodes
- Google Search Central : redirections et recherche Google
- Google Search Central : gérer l’exploration des URL de navigation à facettes
- Google Search Central : versions localisées de vos pages (hreflang)
- Google Search Central : gestion du budget d’exploration
- Aide Search Console : rapport sur l’indexation des pages
- Google Search Central : règles concernant le spam, dont le contenu créé à grande échelle
- Aide Google : signaler du contenu pour des raisons juridiques